大数据处理的双翼 实时与离线数据处理服务解析
引言
在数字化时代,数据已成为企业的核心资产。随着数据量的爆炸式增长,如何高效地处理和分析数据成为关键挑战。大数据处理主要分为两种模式:实时处理和离线处理。这两种模式各有优劣,适用于不同的业务场景。而数据处理服务则为企业提供了灵活、可扩展的解决方案,帮助它们从数据中挖掘价值。
实时处理:即时洞察,驱动实时决策
实时处理(Real-time Processing)是指在数据产生的同时立即进行处理和分析,通常要求在毫秒到秒级内完成。其核心价值在于能够快速响应事件,提供即时洞察。
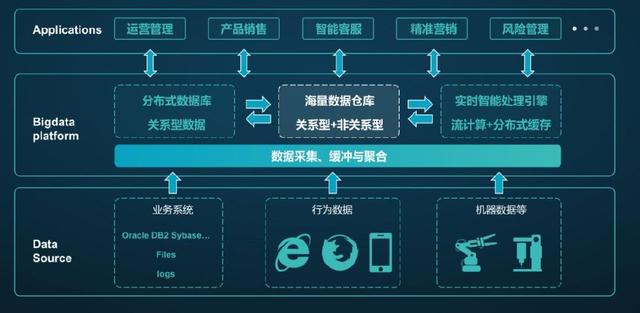
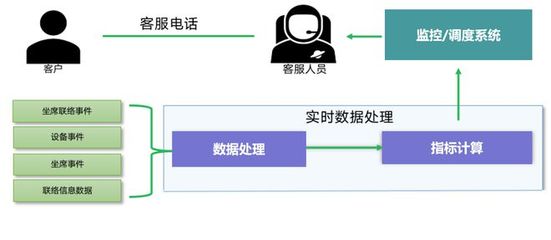
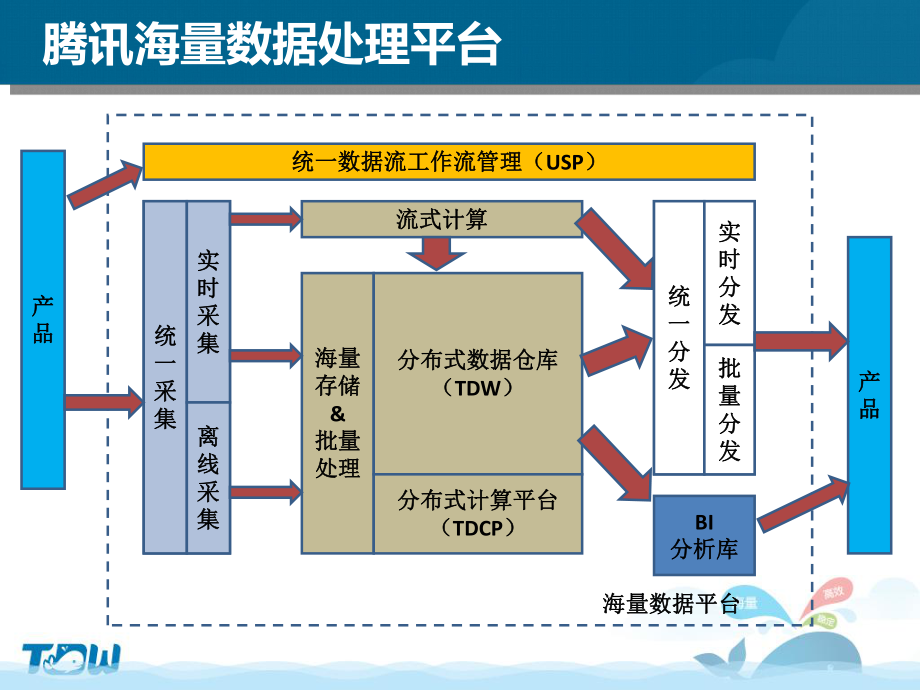
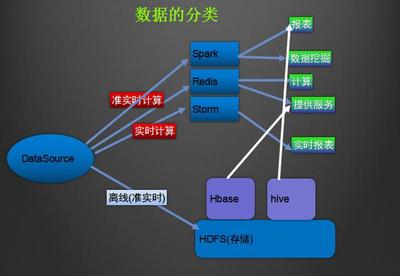
技术栈与架构:实时处理通常涉及流式计算框架,如Apache Kafka(数据管道)、Apache Flink、Apache Storm、Apache Spark Streaming等。这些框架能够处理无界数据流,并支持复杂事件处理。典型架构包括数据采集、消息队列、流处理引擎和实时存储(如Redis、Apache Druid)。
应用场景:实时监控与告警(如金融欺诈检测)、实时推荐系统(如电商个性化推荐)、物联网设备监控、实时风控等。
优势与挑战:实时处理能够提供低延迟的洞察,支持快速决策。但同时也面临数据乱序、Exactly-Once语义、系统复杂性等挑战。
离线处理:批量处理,深度分析
离线处理(Offline Processing)又称批处理,是指在数据累积到一定量后,在特定时间窗口内进行批量处理。它通常处理有界数据集,强调吞吐量和深度分析。
技术栈与架构:离线处理常用Apache Hadoop(MapReduce)、Apache Spark(批处理)、Apache Hive等。数据通常存储在分布式文件系统(如HDFS)或数据湖中。处理流程包括数据抽取、清洗、转换和加载(ETL),最终输出到数据仓库或数据集市。
应用场景:历史数据分析、报表生成、数据挖掘、机器学习模型训练等。
优势与挑战:离线处理能够处理海量数据,成本较低,适合复杂计算。但延迟较高,通常以小时或天为单位,无法满足实时需求。
数据处理服务:托管与集成
随着云计算的普及,数据处理服务(Data Processing Services)以托管形式提供,降低了企业构建大数据平台的复杂性。这些服务通常包括:
- 实时处理服务:如AWS Kinesis、Azure Stream Analytics、Google Cloud Dataflow,提供全托管的流处理能力。
- 离线处理服务:如AWS EMR、Azure Databricks、Google Cloud Dataproc,提供托管的Spark/Hadoop集群。
- 统一数据处理平台:如Databricks(基于Spark)、Snowflake(数据仓库),支持批流一体处理。
数据处理服务的优势在于弹性伸缩、按需付费、免运维,使企业能够聚焦于业务逻辑而非基础设施。
实时与离线的融合:Lambda与Kappa架构
在实际应用中,企业往往需要同时支持实时和离线处理。Lambda架构通过分离批处理层、速度层和服务层来满足混合需求,但维护复杂。Kappa架构则通过统一的流处理管道简化架构,所有数据都作为流处理,历史数据通过重放处理。批流一体技术(如Apache Flink)正成为趋势,它能够用同一套引擎处理有界和无界数据。
##
实时处理和离线处理是大数据处理的两种基本模式,各有适用场景。随着技术的发展,两者的界限逐渐模糊,批流一体成为新的方向。数据处理服务的兴起进一步降低了技术门槛,使企业能够更专注于数据价值的挖掘。我们期待更智能、更高效的数据处理解决方案,助力企业在数据驱动的世界中赢得先机。
如若转载,请注明出处:http://www.henandingcan.com/product/38.html
更新时间:2026-10-30 07:11:28