基于Python的自动化数据处理服务 从任务编排到高效落地
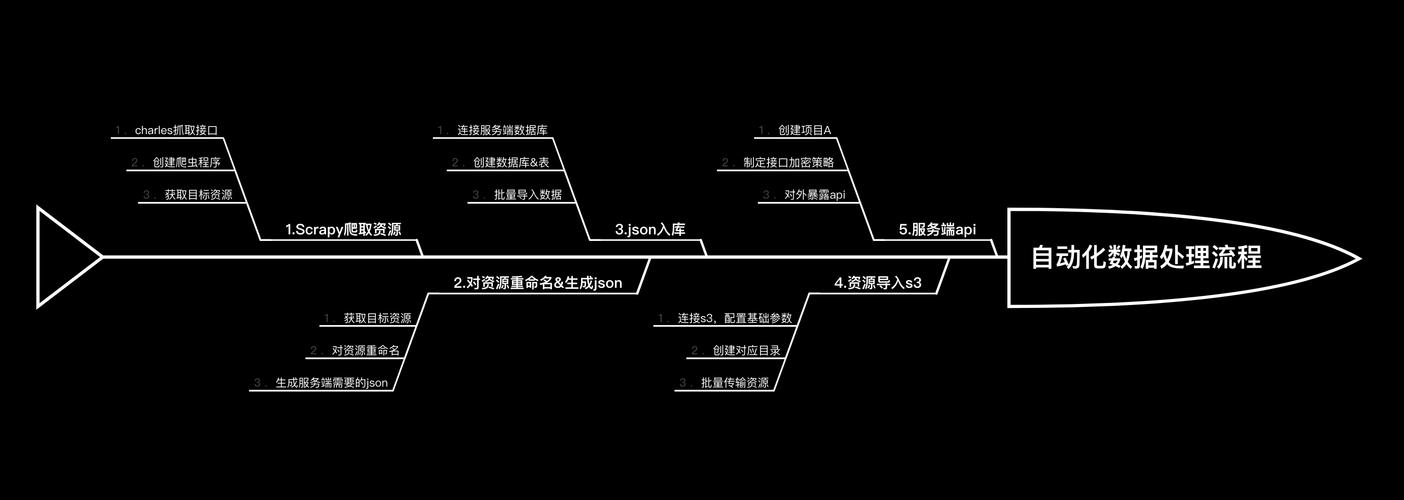
在大数据与业务实时化需求日益增长的今天,手动处理数据不仅效率低下,而且极易出错。无论是每日的报表生成、日志清洗,还是跨系统的数据同步,都迫切需要一套自动化数据处理流程。Python凭借其丰富的生态(Pandas、Airflow、Prefect、FastAPI等),成为构建此类数据处理服务的首选语言。本文将围绕“自动化数据处理流程”和“Python 数据处理服务”两个核心,探讨如何设计并实现一个健壮、可扩展的自动化数据处理服务。\n\n## 一、自动化数据处理流程的核心要素\n\n一个完整的自动化数据处理流程通常包含以下阶段:\n\n1. 数据采集:从数据库、API、文件系统或消息队列中抽取数据。\n2. 数据清洗与转换:处理缺失值、去重、格式转换、字段映射等。\n3. 数据计算与分析:聚合、连接、特征工程或模型推理。\n4. 数据加载/输出:写入数据仓库、生成文件、推送消息或触发下游任务。\n5. 调度与监控:定时触发、依赖管理、失败重试、告警通知。\n6. 元数据与日志:记录每次运行的状态、耗时、数据量,便于审计与排障。\n\n所有这些环节,都可以由Python服务来统一编排和暴露接口。\n\n## 二、为什么选择Python构建数据处理服务\n\n- 生态成熟:Pandas、Polars、Dask处理中型到大型数据;SQLAlchemy操作数据库;Requests/httpx调用API。\n- 调度框架丰富:Airflow、Prefect、Dagster、Luigi,或轻量级的APScheduler。\n- 服务化便捷:FastAPI、Flask快速暴露HTTP接口;Celery或RQ处理异步任务。\n- 可测试与可维护:Python代码结构清晰,配合pytest容易编写单元测试。\n\n## 三、设计一个自动化数据处理服务\n\n下面给出一个参考架构,以满足“自动化”和“服务化”双重需求。\n\n### 3.1 分层架构\n\n- API层:使用FastAPI接收外部请求(如手动触发、查询状态、上传数据文件)。\n- 任务编排层:使用Prefect或Airflow定义DAG,串联多个数据处理任务,并设置调度周期(如每天凌晨2点)。\n- 处理层:独立的Python模块,每个模块完成一个具体的处理步骤,输入输出明确。\n- 存储层:数据库(PostgreSQL/MySQL)、对象存储(S3/MinIO)或数据湖。\n- 监控告警层:Prometheus + Grafana监控指标,或简单企业微信/钉钉/Slack webhook报警。\n\n### 3.2 代码示例:一个微型但完整的服务\n\n以下示例展示如何用FastAPI + Pandas + APScheduler构建一个定时自动清洗CSV并输出统计结果的服务。\n\n`python\n# app/main.py\nfrom fastapi import FastAPI, UploadFile, BackgroundTasks\nfrom apscheduler.schedulers.background import BackgroundScheduler\nimport pandas as pd\nimport os\nfrom datetime import datetime\n\napp = FastAPI(title=\
如若转载,请注明出处:http://www.henandingcan.com/product/26.html
更新时间:2026-10-30 03:41:45